Для разреженных матриц большого размера прямые методы, строящие полное разложение матрицы, как правило, невыгодны: в процессе разложения в позициях исходных нулей возникают новые ненулевые элементы — так называемое заполнение. В результате теряется главное преимущество разреженной матрицы — малый объём памяти и малое число арифметических операций.
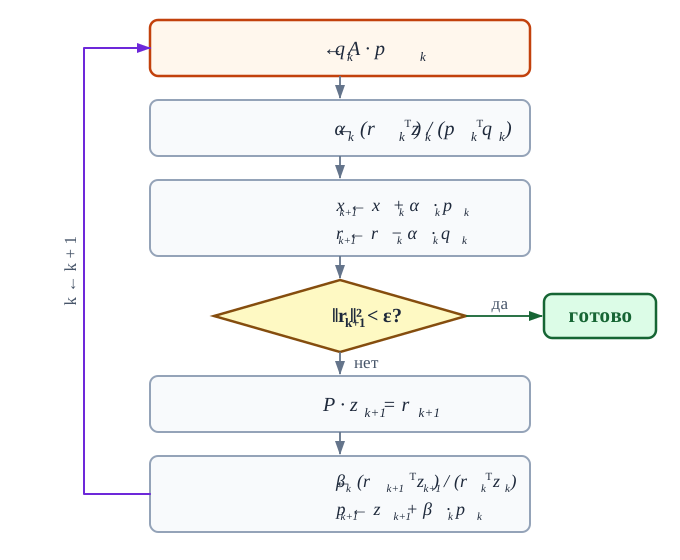
Мы будем решать систему (3.1) итерационным предобусловленным методом сопряжённых градиентов (PCG, preconditioned conjugate gradient). Метод применим к симметричным положительно определённым матрицам — именно такие возникают в задачах МКЭ с эллиптическими операторами и в неявных схемах теплопроводности. Распишем алгоритм по шагам.
Пусть — начальное приближение. Начальный остаток примет вид
Начальное направление поиска и вектор предобуславливания имеют вид
где — матрица предобуславливателя: она приближает , но системы с ней решаются существенно дешевле. Далее на каждой итерации вычисляем
Итерации продолжаются, пока квадрат нормы остатка не опустится ниже заданного порога
Основная вычислительная стоимость каждой итерации — одно умножение разреженной матрицы на вектор . Именно поэтому перед началом итераций матрица конвертируется из COO в CSR: в этом формате умножение строки на вектор проходит только по ненулевым элементам.
Далее поговорим о предобуславливателях.